Quando um utilizador faz uma pergunta ao ChatGPT, ao Perplexity ou ao Gemini, esses sistemas não “navegam” no seu site da mesma forma que um humano. Não lêem o menu, não clicam em botões, não percorrem a página com o rato. O que fazem é processar texto de forma massiva, tentando extrair o contexto e a autoridade de um domínio a partir de fragmentos de conteúdo que, muitas vezes, chegam mal estruturados, incompletos ou misturados com código HTML irrelevante.
A expectativa de muitos proprietários de sites é que basta ter bom conteúdo para ser citado pela IA. Mas isso não é suficiente. Os modelos de linguagem precisam de entender quem é o site, o que oferece e qual o conteúdo que merece atenção, e fazem-no melhor quando existe uma fonte de verdade clara, estruturada e legível por máquinas.
É aqui que entra o ficheiro llms.txt. Neste artigo, explicamos o que é, para que serve, como se compara ao robots.txt e ao sitemap.xml, e como criar o seu passo a passo, com um exemplo concreto para uma agência de marketing digital.
O que é o llms.txt?
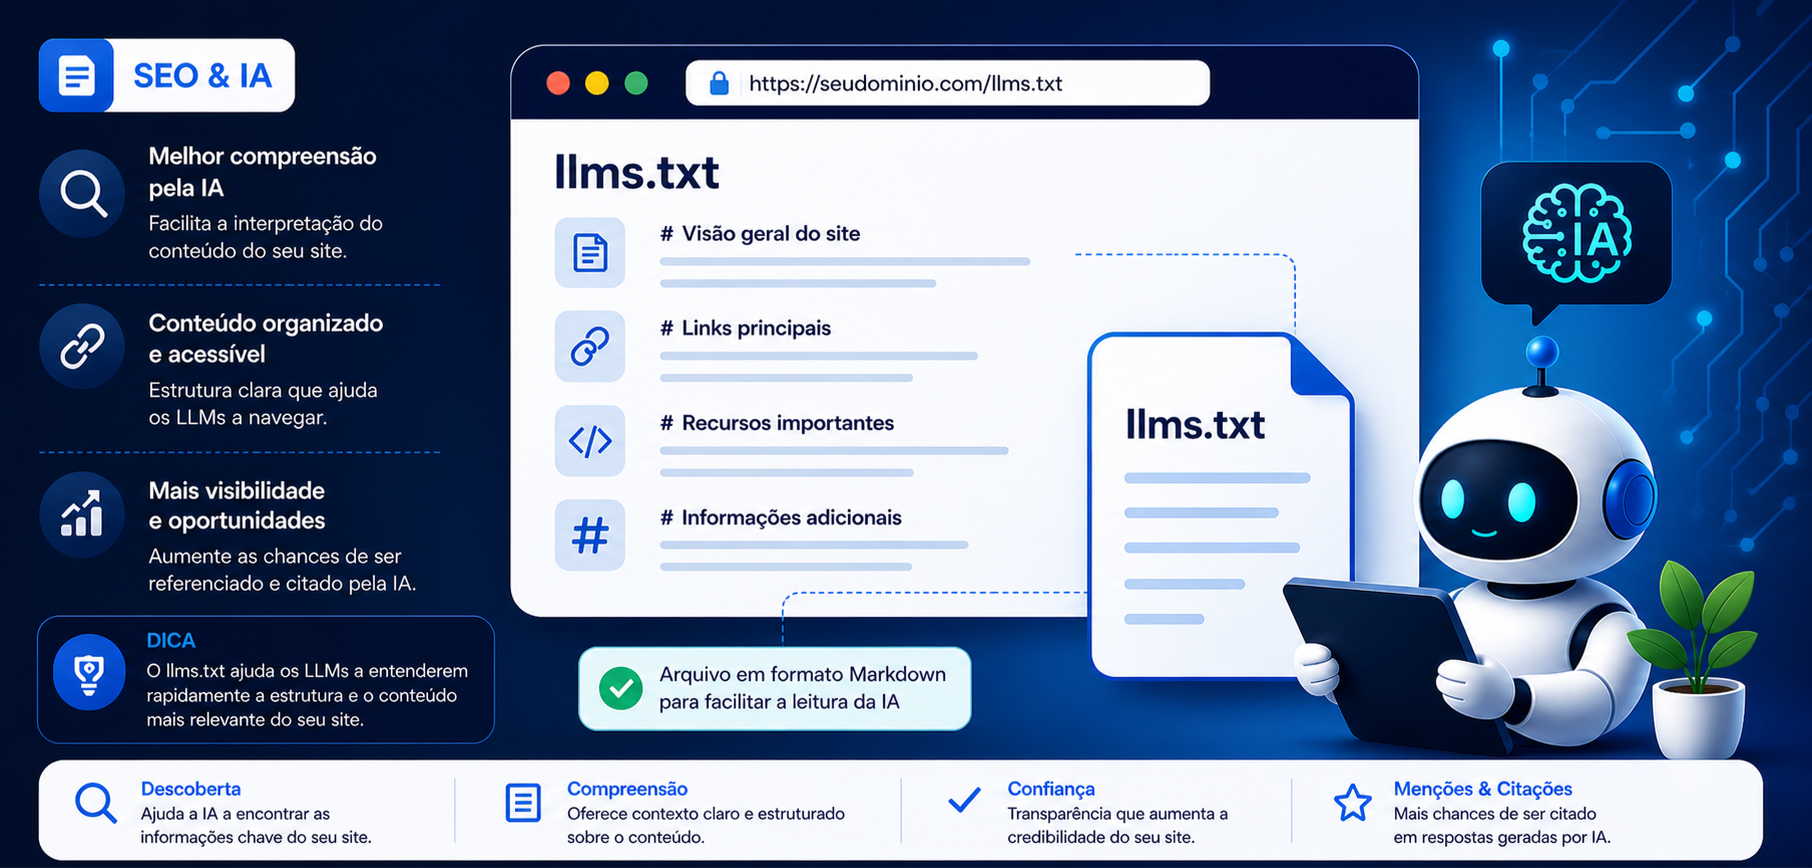
O llms.txt é um ficheiro de texto em formato Markdown, colocado na raiz de um domínio, que fornece aos modelos de linguagem (LLMs) uma visão estruturada e resumida do conteúdo de um site. A proposta foi apresentada por Jeremy Howard, cofundador da fast.ai, em 2024, e rapidamente ganhou tracção na comunidade técnica de SEO e desenvolvimento web.
A analogia mais directa é com o robots.txt. Tal como esse ficheiro comunica com os robots dos motores de busca tradicionais, dizendo-lhes o que podem ou não rastrear, o llms.txt comunica com os sistemas de IA, dando-lhes um mapa claro do que o site contém e como esse conteúdo está organizado.
O ficheiro inclui tipicamente um título, uma descrição breve do site ou organização, e uma lista de secções com links para as páginas mais relevantes, cada um acompanhado de uma descrição curta. O formato Markdown foi escolhido precisamente porque os LLMs processam este formato com grande eficiência, sendo mais limpo e previsível do que HTML.
Para que serve o llms.txt?
Os modelos de linguagem como o ChatGPT, o Perplexity, o Gemini e o Claude têm formas muito próprias de processar informação proveniente da web. Ao contrário de um motor de busca tradicional, que indexa páginas com base em palavras-chave, metadados e backlinks, um LLM tenta compreender o significado, o contexto e a autoridade de uma fonte. E faz isso muitas vezes a partir de texto bruto, sem beneficiar da estrutura visual de uma página.
O llms.txt resolve um problema concreto: dá ao modelo uma entrada única, bem organizada, que resume o essencial do site. Em vez de o sistema ter de inferir o que é importante a partir de dezenas de páginas, encontra num só ficheiro a hierarquia de conteúdos, as áreas temáticas e os recursos mais relevantes. Isto aumenta a probabilidade de o site ser correctamente interpretado e, consequentemente, citado em respostas geradas por IA.
A diferença em relação ao crawling tradicional é significativa. Um motor de busca percorre o site página a página, acumulando sinais ao longo do tempo. Um LLM, quando consulta um domínio em tempo real (como o Perplexity faz), precisa de tomar decisões rápidas sobre relevância e credibilidade. O llms.txt funciona como um briefing executivo: directo, estruturado e pensado para esse tipo de leitura.
llms.txt vs robots.txt vs sitemap.xml
Os três ficheiros coexistem e complementam-se, mas cada um tem uma função distinta e um público diferente.
O robots.txt é lido pelos crawlers dos motores de busca. O seu papel é de controlo de acesso: diz ao Googlebot, ao Bingbot e similares quais as páginas que podem ou não ser rastreadas. Não descreve conteúdo, não explica o contexto do site e não tem qualquer efeito directo sobre os LLMs.
O sitemap.xml também é dirigido aos motores de busca tradicionais. Lista todas as URLs do site, com metadados opcionais como datas de actualização e prioridade relativa. É um mapa de navegação, não uma descrição de conteúdo.
O llms.txt é diferente de ambos. É dirigido especificamente a sistemas de inteligência artificial e modelos de linguagem. Em vez de controlar o acesso ou listar URLs, descreve o que o site é, o que contém e o que merece atenção, em linguagem natural e estrutura Markdown. Não substitui os outros dois ficheiros, mas acrescenta uma camada de comunicação que até agora não existia.
Em termos práticos: um site bem configurado tem os três. O robots.txt gere o crawling, o sitemap.xml facilita a indexação, e o llms.txt garante que os sistemas de IA têm uma representação fiel e útil do conteúdo disponível.
Como criar o seu llms.txt passo a passo
Estrutura obrigatória
Um llms.txt válido segue uma estrutura simples mas bem definida. Começa com um título em H1 (o nome do site ou da organização), seguido de um bloco de descrição em texto corrido que explica o que o site é e para quem serve. A seguir, organiza-se em secções temáticas, cada uma com um título em H2, contendo listas de links com uma breve descrição de cada página.
Esta estrutura não é arbitrária. Os LLMs são treinados para reconhecer hierarquias Markdown e extrair informação com base nelas. Um ficheiro bem estruturado reduz a ambiguidade e aumenta a precisão com que o modelo interpreta o conteúdo do site.
O que incluir?
Inclua as páginas que melhor representam a autoridade e os temas principais do seu site. Isto abrange, tipicamente, a página sobre a empresa ou equipa, as páginas de serviços ou produtos, artigos de blog com maior profundidade técnica ou editorial, páginas de FAQ, casos de estudo e qualquer recurso que demonstre experiência e credibilidade.
O critério essencial é o valor informativo. Se uma página responde a perguntas reais, explica um conceito, demonstra competência ou apresenta provas de qualidade, deve constar no llms.txt. O objectivo é dar ao modelo o melhor que o site tem para oferecer.
O que excluir?
Deixe de fora as páginas que não acrescentam valor informativo para um modelo de linguagem. Páginas de checkout, áreas de cliente, formulários de login, páginas de erro, URLs com parâmetros de sessão, páginas de agradecimento pós-formulário e qualquer conteúdo técnico sem substância editorial não devem constar no ficheiro.
A regra prática é simples: se uma página não responderia a nenhuma pergunta razoável de um utilizador, não tem lugar no llms.txt.
Onde colocar?
O ficheiro deve ser colocado na raiz do domínio, acessível em https://exemplo.pt/llms.txt. Esta localização é a convenção estabelecida e é onde os sistemas de IA procuram o ficheiro. Não o coloque em subpastas, não o renomeie e assegure-se de que está acessível publicamente, sem autenticação ou redirects.
Se o seu site tiver subdomínios com conteúdo autónomo (por exemplo, blog.exemplo.pt), considere criar um llms.txt separado para cada um.
Exemplo prático de llms.txt para uma agência de marketing
O exemplo abaixo mostra como ficaria um llms.txt real para uma agência de marketing digital fictícia chamada “NovaMarca”. Os comentários entre parênteses são explicativos e não fazem parte do ficheiro real.
# NovaMarca — Agência de Marketing Digital
> Somos uma agência de marketing digital especializada em SEO, conteúdo e estratégia
> de presença online para empresas B2B em Portugal. Trabalhamos com marcas que querem
> crescer de forma sustentável nos motores de busca e nos novos canais de IA.
## Sobre nós
(Informação institucional e de contexto)
- [Quem somos](https://novamarca.pt/sobre): História, equipa e valores da NovaMarca.
- [Clientes e casos de estudo](https://novamarca.pt/casos-de-estudo): Resultados concretos para clientes em sectores como tecnologia, saúde e retalho.
## Serviços
(Páginas de serviço com maior valor informativo)
- [SEO técnico e editorial](https://novamarca.pt/servicos/seo): Auditoria, estratégia de keywords e optimização on-page.
- [Produção de conteúdo](https://novamarca.pt/servicos/conteudo): Artigos, guias e whitepapers para atrair tráfego qualificado.
- [AEO — Answer Engine Optimization](https://novamarca.pt/servicos/aeo): Estratégias para aparecer nas respostas geradas por IA.
## Recursos e Blog
(Artigos de autoridade e conteúdo editorial relevante)
- [O que é o AEO e porque importa em 2025](https://novamarca.pt/blog/aeo): Guia completo sobre optimização para motores de resposta.
- [Como estruturar conteúdo para o Google AI Overviews](https://novamarca.pt/blog/ai-overviews): Estratégias práticas.
- [llms.txt: guia de implementação](https://novamarca.pt/blog/llms-txt): Este guia explica como configurar o ficheiro para ser lido por IA.
## FAQ
(Perguntas frequentes com valor informativo directo)
- [Perguntas frequentes sobre SEO e marketing digital](https://novamarca.pt/faq): Respostas às dúvidas mais comuns.
## Contacto
- [Fale connosco](https://novamarca.pt/contacto): Formulário de contacto e informações da equipa.
Este ficheiro, com menos de 30 linhas, dá a qualquer LLM uma visão clara do que a NovaMarca faz, em que áreas é especialista e quais as páginas que devem ser consideradas para referência.
llms-full.txt — a versão extendida
Para além do llms.txt base, existe uma variante chamada llms-full.txt, também prevista na proposta original de Jeremy Howard. A diferença fundamental é a profundidade do conteúdo.
Enquanto o llms.txt fornece um índice com descrições curtas, o llms-full.txt inclui o conteúdo completo das páginas referenciadas, incorporado directamente no ficheiro. É uma versão expandida, pensada para cenários em que o modelo precisa de aceder ao texto completo de cada página sem ter de seguir links externos.
Este formato é especialmente útil para documentação técnica, bases de conhecimento extensas ou sites em que o conteúdo é suficientemente denso para justificar uma leitura aprofundada. Para a maioria dos sites de marketing ou empresas de serviços, o llms.txt base é suficiente e mais fácil de manter actualizado. O llms-full.txt faz mais sentido quando o site tem documentação técnica extensa, como é o caso de produtos de software ou plataformas com APIs.
Impacto do llms.txt no AEO e na visibilidade em motores de IA
A Answer Engine Optimization (AEO) é a disciplina que se ocupa de optimizar conteúdo para aparecer nas respostas geradas por sistemas de inteligência artificial. O llms.txt é uma das ferramentas mais directas ao alcance de qualquer webmaster para melhorar essa visibilidade.
A lógica é simples: os LLMs tendem a citar fontes que conseguem identificar como autoritárias, bem organizadas e relevantes para o tema da pergunta. Um site que apresenta o seu conteúdo de forma estruturada, com contexto claro e links para recursos de qualidade, tem mais probabilidade de ser reconhecido como uma fonte de confiança. O llms.txt contribui directamente para esse reconhecimento.
Há também uma relação com os princípios de E-E-A-T (Experiência, Especialização, Autoridade e Confiança) que o Google aplica nos seus AI Overviews e noutros sistemas de avaliação de qualidade. Um llms.txt bem construído demonstra que o site sabe o que é, conhece a sua audiência e tem conteúdo organizado com intenção editorial. Estes são sinais que um modelo de linguagem valoriza da mesma forma que o Google valoriza os sinais de E-E-A-T.
Em termos de casos documentados, sites que adoptaram o llms.txt após a proposta de 2024 reportaram uma maior consistência nas citações por parte de ferramentas como o Perplexity e o ChatGPT com navegação web activa. Embora os dados ainda sejam limitados (a adoção é recente), a tendência é clara: estruturar o conteúdo para ser lido por IA é vantagem competitiva, não boa prática opcional.
FAQs sobre llms.txt
O llms.txt é um padrão oficial reconhecido pelo Google ou pela OpenAI?
Ainda não existe um padrão formal adoptado por todos os fornecedores de IA. A proposta de Jeremy Howard (fast.ai) é amplamente respeitada e seguida, mas cada sistema de IA tem os seus próprios mecanismos de leitura. O ficheiro é, por enquanto, uma convenção emergente com adoção crescente.
O meu site precisa de saber programar para criar um llms.txt?
Não. O ficheiro é texto simples em formato Markdown. Pode ser criado num editor de texto básico e carregado para o servidor da mesma forma que qualquer outro ficheiro estático.
O llms.txt substitui o robots.txt?
Não. São ficheiros com propósitos distintos. O robots.txt controla o acesso dos crawlers de motores de busca tradicionais. O llms.txt comunica com modelos de linguagem. Ambos devem existir no site.
Os motores de IA lêem o llms.txt automaticamente?
Alguns sistemas, como o Perplexity com acesso à web activado, procuram o ficheiro na raiz do domínio. Outros LLMs podem aceder a ele quando o utilizador fornece o URL do site numa conversa. A adoção por parte dos sistemas de IA está a crescer.
O llms.txt afecta o SEO tradicional?
Directamente, não. O ficheiro não é lido pelo Googlebot nem interfere com a indexação tradicional. Indirectamente, ao melhorar a visibilidade em ferramentas de IA que geram tráfego referenciado, pode contribuir para mais visitas e maior autoridade percebida.
Com que frequência devo actualizar o llms.txt?
Sempre que houver mudanças significativas no site: novos serviços, novos conteúdos de autoridade, alterações na estrutura principal ou remoção de páginas importantes. Uma revisão trimestral é uma boa prática de base.
Posso incluir páginas em idiomas diferentes no mesmo llms.txt?
Sim. Se o site tem conteúdo em português e inglês, pode listar páginas em ambos os idiomas, indicando o idioma em cada descrição para facilitar a interpretação pelo modelo.
O llms.txt deve ser indexado pelo Google?
Não há razão para o bloquear, mas também não é necessário garantir que é indexado pelo Google. O ficheiro é dirigido a LLMs, não a motores de busca tradicionais. Pode, no entanto, ser útil que o Google o conheça, para que seja acessível via pesquisa se alguém o procurar directamente.
O que acontece se o meu llms.txt tiver erros de formato?
Os LLMs são razoavelmente tolerantes a erros de formatação Markdown, mas um ficheiro mal estruturado pode ser interpretado incorrectamente ou ignorado. Vale a pena validar o formato antes de publicar.
Existe alguma ferramenta que gere o llms.txt automaticamente?
Já existem plugins para WordPress e ferramentas online que geram um llms.txt básico a partir da estrutura do site. No entanto, o resultado automático deve ser sempre revisto manualmente para garantir que as descrições são precisas e que as páginas mais relevantes estão incluídas.
O llms.txt pode prejudicar o meu site de alguma forma?
Não existe qualquer risco conhecido. O ficheiro é público e acessível, tal como o robots.txt. A única precaução é não incluir informação sensível ou privada no ficheiro, uma vez que qualquer pessoa (ou sistema) o pode ler.
O llms-full.txt é sempre melhor que o llms.txt base?
Não necessariamente. Para sites de marketing ou empresas de serviços, o llms.txt base é suficiente e mais fácil de manter. O llms-full.txt faz sentido quando o site tem documentação técnica extensa ou conteúdo muito denso que os LLMs precisam de ler na íntegra.
Quem deve ser responsável por criar e manter o llms.txt na empresa?
Tipicamente, a responsabilidade partilha-se entre o webmaster ou equipa técnica (para a parte de publicação e actualização do ficheiro) e a equipa de conteúdo ou SEO (para definir quais as páginas que devem ser incluídas e como devem ser descritas).
Conclusão
O llms.txt é, sem exagero, o robots.txt da era da inteligência artificial. Assim como, nos anos 90, os sites que configuravam correctamente o robots.txt tinham vantagem na indexação pelos primeiros motores de busca, hoje os sites que adoptam o llms.txt estão a posicionar-se melhor para serem lidos, compreendidos e citados pelos sistemas de IA que estão a transformar a forma como as pessoas encontram informação online. A janela de vantagem para os early adopters existe, e está aberta agora.
Se quer garantir que o seu site é visível nos novos motores de resposta, se pretende melhorar a sua estratégia de AEO e se precisa de ajuda a estruturar o conteúdo para ser citado por IA, a Bluesoft pode ajudar.